RAG Arena
Vamos a montar un RAG arena.
Un RAG es bastante sencillo de entender. También bastante tonto.
Por suerte, tenemos algunos trabajos (seguro que habrá más, pero de momento estos son los que tengo fichados) que intentan mejorar las limitaciones de este sistema para que sea más fiable (o parezca menos idiota por lo menos). Hablo de los papers de Self-RAG, Corrective RAG y Adaptive RAG. Los tres proponen añadirle algún tipo de criterio a un pipeline de recuperación, y los tres reportan mejoras.
La idea es simple: pillar un dataset decente, un RAG baseline y medir el delta en la mejora (y coste) de cada uno de estos sistemas.
Limitaciones del RAG clásico
Recordemos lo que hace un RAG vanilla: llega una pregunta \(x\), se recuperan los \(k\) documentos más parecidos, se le pegan al prompt del LLM, y el LLM escribe la respuesta.
Los tres papers arrancan de la misma observación, y cada uno la formula a su manera:
- Recupera siempre, y sin comprobar si lo recuperado sirve. Self-RAG lo dice directamente: recuperar un número fijo de pasajes indiscriminadamente, sin importar si la recuperación era necesaria o si los pasajes son relevantes, reduce la versatilidad del modelo y puede llevar a respuestas peores. El retriever devuelve \(k\) documentos porque le has pedido \(k\); que sirvan es otra cuestión, y nadie la plantea.
- La respuesta no tiene garantía de ser consistente con lo recuperado. También de Self-RAG: los modelos no están entrenados explícitamente para seguir los hechos de los pasajes que reciben. Puedes tener tres documentos correctos delante y responder con lo que haya en los pesos.
- Si la recuperación falla, falla todo lo demás. Es el punto de partida de Corrective RAG: cuando el retriever devuelve documentos irrelevantes, no hay generación que lo arregle, porque el sistema no tiene ningún mecanismo para darse cuenta.
- Todas las preguntas cuestan lo mismo, aunque no lo valgan. El de Adaptive RAG: aplicar la misma estrategia a una pregunta trivial y a una que necesita varios saltos es ineficiente en un sentido e insuficiente en el otro.
Puestos así, se ve el patrón: el pipeline clásico no toma ninguna decisión. Es una tubería recta. Y los tres papers son, en el fondo, tres formas distintas de meterle decisiones.
Los tres puntos de decisión
Si te fijas, las limitaciones de arriba se corresponden con tres preguntas, y cada una vive en un punto distinto del pipeline:
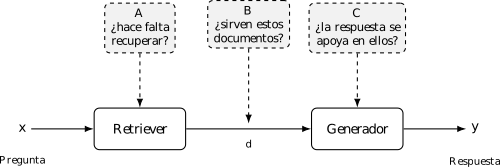
Y aquí está lo interesante: cada paper ataca un subconjunto distinto de esos tres puntos.
| A: ¿recuperar? | B: ¿sirven los docs? | C: ¿está fundamentado? | |
|---|---|---|---|
| RAG vanilla | siempre | no lo pregunta | no lo pregunta |
| Self-RAG | sí, bajo demanda | sí, doc a doc | sí, segmento a segmento |
| Corrective RAG | siempre | sí, y actúa si no sirven | no (refina antes de generar) |
| Adaptive RAG | sí, y decide cuántas veces | lo delega a la estrategia elegida | no |
Self-RAG (Asai et al., 2023) entrena al modelo para que emita reflection tokens mientras genera: cuándo recuperar, si el documento es relevante, si lo escrito está respaldado y si aporta. Y no genera de un tirón, sino por segmentos, haciendo un beam search en el que la puntuación de cada candidato sale de esos tokens. Es el que toca los tres puntos, y el más ambicioso.
Corrective RAG (Yan et al., 2024) mete un evaluador de recuperación ligero que clasifica lo recuperado y dispara una acción correctiva distinta según el caso, incluyendo refinar los documentos antes de pasarlos al generador. Todo su esfuerzo está en el punto B.
Adaptive RAG (Jeong et al., 2024) pone un clasificador de complejidad delante de todo y enruta cada pregunta a una estrategia distinta: sin recuperación, con un solo paso, o con recuperación iterativa. Va a por el punto A, y su métrica interesante no es solo el acierto, es el acierto por unidad de coste.
El dataset
Como dataset para este experimento, el todopoderoso Claude nos recomienda este: MuSiQue del dataset Chaplain0908/RAGRouter, que trae corpus y preguntas ya emparejados.
Le he pedido un dataset que pueda descargar de Hugging Face, con el que pueda medir distintos tipos de RAG, y que quepa en mi portátil.
| Tamaño | |
|---|---|
| Documentos del corpus | 21.100 |
| Preguntas | 3.356 |
Cada pregunta viene con su respuesta de referencia, su tipo, y —esto es lo importante— sus supporting_facts: qué documentos del corpus eran los que de verdad hacían falta para responderla. Esto es bastante interesante:
Además, las preguntas vienen etiquetadas en tres variantes de lo mismo:
| Tipo | Preguntas | % | Docs de soporte | Forma de la respuesta |
|---|---|---|---|---|
multi_hop |
2.590 | 77,2 % | 2 a 4 | una entidad, dos o tres palabras |
single_hop |
398 | 11,9 % | siempre 1 | una entidad, dos o tres palabras |
summary |
368 | 11,0 % | siempre 5 | un párrafo de ~100 palabras |
Bueno, esto es ya lo más. Antes de meterme con esto no había escuchado el concepto multi-hop en mi vida. Pero resulta que MuSiQue es un dataset de multi-hop QA: preguntas construidas a propósito para que haya que encadenar varios documentos, y no solo encontrar uno.
Aquí un ejemplo real.
Who is the spouse of the Green performer? Respuesta: Miquette Giraudy
Para responder correctamente a esa pregunta el dataset no contiene ninguna pieza de información que se pueda usar directamente. Obliga a dar dos saltos:
- Un documento dice que Green es el cuarto álbum de estudio de Steve Hillage. Eso no responde la pregunta, pero establece el eslabón.
- Otro documento dice que Miquette Giraudy es teclista y que su pareja es Steve Hillage. Ahí está la respuesta.
Fíjate en lo que implica esto para un RAG normal: puedes recuperar el documento del paso 1, que es correcto y es relevante, y aun así responder mal, porque con ese documento la respuesta no existe. Hace falta volver a buscar con lo que acabas de aprender.
Esto realmente favorece cualquier sistema de RAG agéntico, por lo que los resultados que obtengamos sabemos que van a estar ligeramente sesgados hacia sistemas que permitan recuperar de lo aprendido. Es decir, con un retriever habitual de una etapa, los resultados que obtengamos sobre esas preguntas multi-hop van a ser peores, evidentemente.
Hay cosas bastante guays en el dataset la verdad, como temas de similitud léxica: hay entidades distintas que comparten título (hay seis documentos titulados “Green”, uno de ellos sobre el simbolismo del color verde en el Egipto antiguo). Así que la similitud léxica con la pregunta puede llevarte perfectamente al documento equivocado, que es justo lo que un juicio de relevancia debería filtrar.
Tampoco voy a perder mucho tiempo con las particularidades del dataset, porque darían para un análisis en sí mismo, pero algunas otras son:
El dataset es muy desequilibrado. Más de tres cuartas partes son multi-hop, lo que va a favorecer el comportamiento de los métodos que recuperan varias veces. Es un sesgo del que hay que ser consciente. Para que las minorías digan algo habrá que muestrear de forma balanceada.
Los summary son otra tarea. Un multi-hop se responde con dos palabras; un summary con unas cien, y siempre a partir de cinco documentos.
El Retrieval Baseline
Como baseline voy a utilizar un mecanismo de RAG habitual en sus variantes densa, híbrida e híbrida más un modelo reranker. Lo he diseñado como un único nodo, el cual será común para todas las implementaciones.
| Modo | Qué hace |
|---|---|
dense |
solo vector denso, similitud cosine |
hybrid |
denso + disperso, fusionados con RRF dentro de Qdrant |
hybrid-rerank |
lo anterior, y un cross-encoder (bge-reranker-v2-m3) reordena los candidatos y se queda con los mejores |
Al reranker le he puesto un umbral de relevancia (0.15) para que no me devuelva shit.
El corpus (MuSiQue) está indexado con bge-m3, que en una sola pasada devuelve dos representaciones de cada documento: un vector denso de 1024 dimensiones (la semántica) y unos pesos dispersos (importancia léxica, tipo BM25 pero aprendida). O sea, los dos carriles de un retriever híbrido salen del mismo modelo.
Como vector store uso Qdrant embebido en local (más que suficiente para esto) y lo elegí sobre Chroma o FAISS porque te permite guardar el vector denso y el disperso en el mismo punto y fusiona los dos carriles con RRF1 dentro de la propia query.
Los documentos se indexan enteros, sin chunking. Los pasajes del corpus que vamos a usar son cortos y no lo necesitan, y eso simplifica el proceso.
Evaluación del sistema
Para la evaluación vamos a combinar métricas deterministas, calculadas directamente a partir del dataset y de la ejecución, con métricas basadas en LLM-as-a-Judge proporcionadas por RAGAS. Esta separación permite evaluar de forma independiente la recuperación de información, la corrección de la respuesta y su fidelidad a la evidencia.
Métricas deterministas
El dataset proporciona el campo supporting_facts (qué documentos contienen la evidencia necesaria para responder cada pregunta), lo que permite evaluar la recuperación directamente.
Calculamos retrieval recall y retrieval precision sobre los documentos que finalmente se utilizan para generar la respuesta:
\[ \text{recall} = \frac{|\text{used} \cap \text{gold}|}{|\text{gold}|}, \qquad \text{precision} = \frac{|\text{used} \cap \text{gold}|}{|\text{used}|} \]
El recall indica qué proporción de la evidencia necesaria consiguió encontrar el sistema (de todos los documentos relevantes, ¿cuántos consigo recuperar?), mientras que la precision mide qué proporción de los documentos utilizados eran realmente relevantes (de los documentos recuperados, ¿cuántos son realmente relevantes?).
Esta distinción es especialmente útil al comparar estrategias de recuperación: una puede aumentar el recall recuperando más evidencia, pero hacerlo a costa de introducir contexto irrelevante.
Métricas LLM-as-a-Judge
Las métricas anteriores no son suficientes para evaluar semánticamente una respuesta. Que la referencia aparezca en el texto no garantiza que la respuesta sea correcta, y tampoco permite determinar si las afirmaciones generadas están respaldadas por la evidencia.
Para este tipo de mediciones es más común el uso de RAGAS, una librería de evaluación que implementa métricas basadas en LLM-as-a-Judge con prompts y protocolos de evaluación predefinidos.
Utilizamos dos métricas: AnswerAccuracy y Faithfulness.
AnswerAccuracy evalúa si la respuesta generada es semánticamente consistente con la referencia. Implementa el esquema de doble juez de NVIDIA: primero evalúa (pregunta, respuesta, referencia) y después repite el juicio intercambiando respuesta y referencia.
El sistema de doble juez consiste básicamente en medir la respuesta contra la referencia dos veces, intercambiando los papeles de respuesta y referencia:
| Evaluación | Se considera «respuesta» | Se considera «referencia» | Pregunta al juez |
|---|---|---|---|
| 1 | Respuesta generada | Gold/reference | ¿Hasta qué punto la respuesta es correcta respecto a la referencia? |
| 2 | Gold/reference | Respuesta generada | La misma evaluación, intercambiando sus papeles |
Esto es importante porque el juicio de un LLM no es necesariamente simétrico: evaluar A respecto a B puede producir un resultado diferente de evaluar B respecto a A. El segundo juicio permite detectar y amortiguar este sesgo.
El esquema de funcionamiento sería el siguiente:
            ┌─ Evaluación 1: Respuesta → Referencia ─► 0 / 2 / 4 ─┐
Pregunta ─► ┤                                                     ├─► Normalizar ─► Media ─► AnswerAccuracy
            └─ Evaluación 2: Referencia → Respuesta ─► 0 / 2 / 4 ─┘                         {0, .25, .5, .75, 1}
El juez determina hasta qué punto la respuesta es correcta respecto a la referencia y asigna una puntuación de 0 (incorrecta), 2 (parcialmente correcta) o 4 (correcta). Por tanto, AnswerAccuracy puede tomar únicamente cinco valores: 0, 0.25, 0.5, 0.75 y 1.
Por ejemplo, si el primer juicio considera la respuesta completamente correcta (4) pero el segundo la considera solo parcialmente correcta (2), el resultado de AnswerAccuracy será: \(\frac{1 + 0.5}{2} = 0.75\). Los valores 0.25 y 0.75 son especialmente informativos, ya que indican que las dos evaluaciones no han llegado a la misma conclusión sobre la equivalencia entre respuesta y referencia.
Faithfulness, en cambio, mide si la respuesta está respaldada por los documentos utilizados como contexto. RAGAS descompone primero la respuesta en afirmaciones atómicas y evalúa después cuáles pueden inferirse de la evidencia:
\[ \text{Faithfulness} = \frac{\text{afirmaciones respaldadas}} {\text{afirmaciones totales}} \]
Así, las métricas deterministas permiten medir qué evidencia recuperamos y si la respuesta esperada aparece en la generación, mientras que RAGAS permite evaluar si la respuesta es semánticamente correcta y si está fundamentada en la evidencia utilizada.
Y por último, mediremos los dineros. Es casi obvio que un sistema iterativo va a ser capaz de 1) rescatar mejores o más útiles documentos para tu query desde la db y 2) dar mejores respuestas basándose en esos documentos… pero ¿a qué coste? Es evidente, también, que tendrá un coste en latencia y tokens. Intentaremos medirlo.
Con todo esto definido, solo queda funcionar; todo el código del experimento está en el repositorio de RAG Arena.
Referencias
Los tres papers:
- Asai, Wu, Wang, Sil, Hajishirzi (2023) — Self-RAG: Learning to Retrieve, Generate and Critique through Self-Reflection
- Yan, Xu, Ran, Zhu, Wang, Wu (2024) — Corrective Retrieval Augmented Generation
- Jeong, Baek, Cho, Hwang, Park (2024) — Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity
El dataset y el original de MuSiQue:
Chaplain0908/RAGRouteren Hugging Face- Trivedi, Balasubramanian, Khot, Sabharwal (2022) — MuSiQue: Multihop Questions via Single-hop Question Composition
Las herramientas:
Y el código de todo esto:
Notas
Reciprocal Rank Fusion: fusionas dos rankings sumando \(1/(k + \text{rank})\) para cada documento. Es una fusión por posición, no por puntuación, así que da igual que las escalas de los dos carriles no tengan nada que ver entre sí.↩︎